
Dans les équipes data qui ont franchi le pas, presque tout le code est écrit par une IA. Et pourtant, une livraison, tableau de bord, indicateur ou simple fonctionnalité, met toujours des semaines, souvent des mois, à arriver chez ceux qui l'ont demandée.
Le problème n'est pas dans les outils. Une plateforme data est une chaîne industrielle : on ingère, on modélise, on analyse, on restitue. L'IA a été installée à chaque poste, et chaque poste va dix fois plus vite. Entre les postes, en revanche, rien n'a changé. Des humains se passent le relais, avec un ticket, une spécification, une recette, une validation. Ces relais prennent le même temps qu'avant.
Les sprints et l'agilité ont été conçus pour coordonner des humains qui codent. Quand le code ne prend plus que quelques minutes, le sprint de deux semaines devient la principale source d'attente.
La conclusion dérange. Dans la chaîne telle qu'elle est organisée aujourd'hui, c'est l'humain placé en relais qui ralentit tout. Voilà pourquoi les gains de productivité de l'IA ne se voient pas encore. On ne va pas retirer l'humain pour autant. On va le sortir de la chaîne et le placer au-dessus, là où il décide, explique et signe, pendant que les agents font circuler le travail.
Le marché de l'emploi data va se redessiner en trois temps. D'abord un transfert : les grandes équipes auront besoin de moins de monde, et ces compétences iront équiper des entreprises plus petites, qui accèdent pour la première fois à une vraie plateforme data et qui en ont besoin pour profiter de l'IA. Ensuite une délégation à des rôles IT plus larges, à mesure que les agents gagnent en autonomie. Enfin l'automatisation complète. Il n'y aura pas plus d'emplois data. Il y aura des plateformes data partout.
Le code n'est plus le goulot
Pendant vingt ans, la data s'est organisée autour d'une rareté : le temps de quelqu'un qui sait écrire une requête, un pipeline, un modèle, un tableau de bord. Les équipes, les rôles, les méthodes et les plannings en découlaient.
Cette rareté a disparu en deux ans. Une transformation, une ingestion, un test de qualité, un tableau de bord, une interface : un agent les conçoit et les produit en quelques minutes, souvent mieux documentés qu'à la main.
On aurait dû voir les délais s'effondrer. Parfois, c'est le cas. Le plus souvent, ils n'ont presque pas bougé. Demandez à un responsable métier combien de temps il attend un nouvel indicateur. Il vous répondra la même chose qu'en 2020. Dans une entreprise moyenne ou grande, un tableau de bord met encore trois mois à être en ligne, alors que la requête derrière tient parfois en vingt lignes.
Si le code va dix fois plus vite et que le résultat arrive à peine plus tôt, c'est que le code n'était pas le problème.
La chaîne et ses relais
Une plateforme data fonctionne comme une ligne de production. Une demande entre d'un côté ; de l'autre sort une livraison : un tableau de bord, un indicateur fiable, un flux vers un autre système, ou simplement une nouvelle fonctionnalité. Entre les deux, quatre postes : ingérer la source, modéliser, analyser, restituer.
Chaque poste est tenu par un métier différent, data engineer, analytics engineer, analyste, développeur BI. Et entre deux postes, il y a un relais. Le travail attend dans un backlog, une spécification circule, quelqu'un fait la recette, quelqu'un d'autre valide. Un relais suppose un humain disponible, qui comprend ce qu'on lui passe et qui décide de s'y mettre maintenant plutôt que la semaine prochaine.
L'industrie connaît ce problème depuis quarante ans. Goldratt l'a écrit dans The Goal : accélérer un poste qui n'est pas le goulot n'accélère pas la chaîne. La figure 1 le montre sur une demande typique.
Le parcours d'une demande d'indicateur
Voilà le paradoxe. Les équipes ont vraiment gagné en productivité, poste par poste. Mais le délai que voit le métier est fait de relais, et les relais sont faits d'agendas, de réunions, de files d'attente et de « je regarde ça la semaine prochaine ».
Le temps ne se perd plus dans le travail. Il se perd entre les mains.
Le sprint est un rythme d'humain
Le Manifeste agile date de 2001. Il a été écrit pour des développeurs humains qui avaient besoin de se coordonner, de découper le travail en morceaux digestes et de faire le point souvent. Le sprint de deux semaines répondait à une contrainte bien réelle : un humain met des jours à produire une fonctionnalité.
Cette contrainte a disparu. Une tâche qui prend vingt minutes à un agent attend pourtant, en moyenne, une semaine qu'un sprint commence, puis la revue de fin de sprint pour être livrée. Le sprint regroupe le travail par paquets, et un paquet fait attendre tout ce qui arrive entre deux départs.
L'agilité n'est pas en cause. Elle a été pensée pour un monde où le travail était lent et la coordination coûteuse. Dans un monde où le travail est presque instantané, la cadence elle-même devient la latence.
Même flux de demandes, deux organisations
Un moteur électrique dans une usine à vapeur
Ce paradoxe a un précédent. En 1987, les ordinateurs avaient envahi les bureaux, et pourtant la productivité des entreprises ne progressait pas plus vite qu'avant. L'économiste Robert Solow l'a résumé d'une phrase restée célèbre : l'ère informatique se voit partout, sauf dans les chiffres de productivité. Les gains ont mis encore dix ans à apparaître.
Quelques années plus tard, l'historien de l'économie Paul David a trouvé l'explication dans l'électricité. Les premières usines électrifiées ont remplacé leur machine à vapeur centrale par un gros moteur électrique, en gardant les mêmes arbres de transmission et le même plan d'atelier. Les gains ont été minimes. La rupture est venue quand on a redessiné les usines autour d'un petit moteur par machine. Cela a pris une génération.
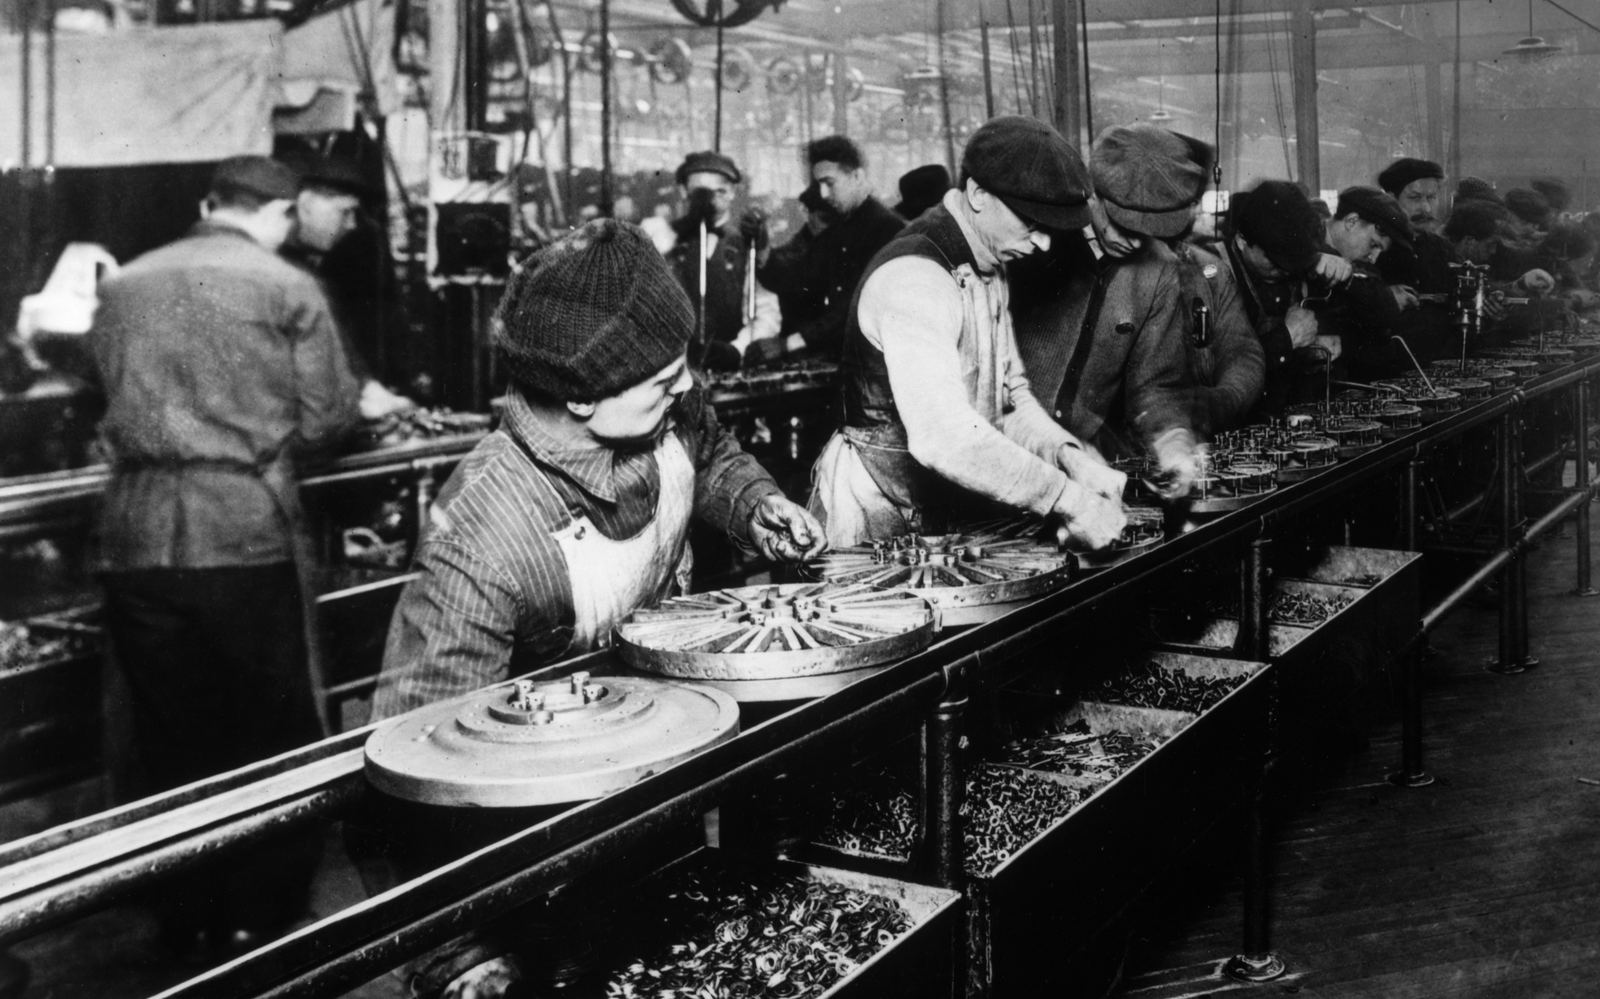
- 1880La machine à vapeur centraleUn seul moteur, des arbres de transmission, des courroies. L'usine est dessinée autour de lui.
- 1900Le moteur électrique la remplaceMême plan d'atelier, mêmes arbres, mêmes courroies. Les gains sont minimes.
- 1920Un petit moteur par machineL'usine est redessinée autour des machines. La productivité décolle enfin.
- 2026L'IA dans l'organisation existanteMêmes rôles, mêmes tickets, mêmes sprints. Le plan d'usine reste à redessiner.
Les équipes data vivent ce moment. On a branché l'IA sur l'organisation existante, avec les mêmes rôles, les mêmes tickets, les mêmes sprints, les mêmes comités. Un moteur électrique dans une usine à vapeur.
Les gains de l'IA ne viendront pas d'outils plus puissants. Ils viendront d'un plan d'usine différent.
Sortir l'humain de la chaîne
Dans la chaîne telle qu'elle existe, l'humain ralentit tout. Pas parce qu'il travaille mal. Parce qu'il est au mauvais endroit. On lui demande de porter le travail d'un poste à l'autre, ce qu'un agent fait sans dormir, sans réunion et sans file d'attente.
Supprimer les humains n'est pas une option. Une plateforme sans humains produit des chiffres que personne ne comprend et que personne n'assume. Ce qu'il faut changer, c'est leur position. L'humain sort de la chaîne et se place au-dessus.
Concrètement, les agents font circuler le travail en continu. Ils ingèrent, modélisent, testent, documentent, surveillent, corrigent. Les humains interviennent là où personne ne peut les remplacer. Ils décident de ce qui compte, expliquent ce que les chiffres ne disent pas, signent avant que quoi que ce soit touche la production, et donnent le contexte qui fait progresser l'agent.
De la chaîne de relais à la boucle
Ce déplacement règle le problème des relais. Plus de passage de main entre postes, donc plus d'attente entre postes. Il reste un point de contact humain par décision, au moment où elle compte. Et ce point de contact devient plus intéressant. Au lieu de recetter un pipeline, on explique pourquoi la marge a baissé à Roubaix ce trimestre.
Les agents remontent les faits. Les humains donnent le contexte. C'est une boucle, pas une chaîne.
Les métiers de la data, redessinés
Si les relais disparaissent, les métiers qui en vivaient disparaissent aussi sous leur forme actuelle. Autant le dire calmement, parce que c'est déjà en cours. Les postes d'exécution se raréfient. Les postes de jugement prennent leur place, pour un temps.
Une équipe data d'entreprise moyenne compte aujourd'hui entre dix et vingt personnes, organisées par poste. Demain, quelques pilotes de plateforme suffiront à faire tourner l'ensemble, avec des équipes métier bien plus présentes dans la définition et l'explication des chiffres.
Pour les gens de la data, ce n'est pas forcément une mauvaise nouvelle. C'en est une pour les rôles qui consistaient à porter du travail d'un endroit à un autre. Ceux qui savent juger, arbitrer et expliquer vont devenir plus rares, donc plus précieux. Et le travail le moins intéressant du métier, celui que tout le monde fuyait, disparaît en premier.
La plateforme data descend vers les plus petites entreprises
On pourrait lire tout ce qui précède comme une mauvaise nouvelle, moins de monde dans les équipes data. C'est la moitié du mouvement.
Jusqu'ici, une plateforme data digne de ce nom était un luxe de grand groupe. Il fallait dix à vingt personnes pour la construire et la faire tourner. Une PME, une ETI ou une scale-up qui vient de lever ne pouvait pas se l'offrir. Elle vivait avec des exports Excel, un outil de BI branché en direct sur le logiciel de gestion, et une personne qui faisait un peu de tout (#couteausuisse).
Deux choses changent en même temps. Quand les agents font tourner la chaîne, le coût d'une plateforme s'effondre, parce qu'il ne faut plus une équipe mais un pilote. Et ces entreprises en ont soudain besoin. Elles veulent profiter de l'IA comme les grands groupes, et une IA branchée sur des données éparpillées, non vérifiées et sans définitions communes produit des réponses fausses avec beaucoup d'assurance. Pas de données fiables, pas d'IA utile.
Les grandes équipes vont se resserrer. Les compétences qu'elles libèrent vont équiper des dizaines de milliers d'entreprises qui n'avaient jamais eu de plateforme data.
Le transfert : moins de personnes data dans les grandes, beaucoup plus d'entreprises équipées
Il ne s'agit pas de créer de l'emploi. Dans un premier temps, il s'agit d'un transfert. Il y aura moins besoin de spécialistes et d'hyper-spécialisation, moins de data engineers par grand groupe, moins de postes dédiés à une seule étape de la chaîne. Mais les grandes entreprises se comptent en dizaines de milliers et les petites en millions, alors le total tient. Une personne data pour sept petites entreprises, c'est déjà deux cent mille personnes à l'échelle européenne, plus du double de ce qui restera dans les grandes.
Ce transfert prendra plusieurs formes. Des data engineers et des analystes deviendront pilotes de plateforme, en interne dans une entreprise de cinquante personnes ou en indépendant pour plusieurs entreprises à la fois. Des cabinets et des ESN vendront l'exploitation de plateformes opérées par des agents plutôt que des jours-homme.
Ce n'est qu'un premier temps. Dans tous les secteurs déjà passés par l'automatisation, la suite est connue.
- Temps 1 · Le transfertLes emplois data quittent les grandes équipes et vont équiper les PME. Le total reste à peu près stable. Les métiers changent : moins de spécialistes, plus de pilotes.
- Temps 2 · La délégationLes agents de domaine gagnent en autonomie. Opérer la plateforme cesse d'être un métier à part entière et devient une responsabilité parmi d'autres d'un rôle plus large de management IT, comme on gère aujourd'hui le réseau, la sécurité ou le poste de travail.
- Temps 3 · L'automatisation complèteLa plateforme se pilote seule. Il ne reste aux humains que la gouvernance : décider ce qui compte, signer ce qui part en production, expliquer ce que les chiffres ne disent pas. Sans rôle data dédié.
Les emplois data dédiés, en trois temps
Ce que ce mouvement laisse derrière lui, ce ne sont pas des emplois. Ce sont des plateformes. Des dizaines de milliers d'entreprises équipées d'une plateforme data à l'état de l'art, là où quelques centaines de grands groupes y avaient accès. La diffusion de l'IA dans l'économie se jouera là, dans le tissu des entreprises moyennes qui n'avaient jusqu'ici ni les données ni l'équipe pour s'en servir.
Il n'y aura pas plus d'emplois data. Il y aura des plateformes data partout.
Des agents de domaine, une BI remodelée
Tout ce qui précède décrit les agents d'aujourd'hui. Ils sont jeunes, mais la direction ne fait plus débat : quoi qu'il arrive, le travail de la data passera par des agents. Reste à dire ce que cela change pour ceux qui s'en servent.
Des agents de domaine, nourris de contexte. Les agents actuels sont des généralistes à qui l'on donne des instructions. Ceux de demain embarquent le savoir-faire d'un métier précis et connaissent les cas que l'on rencontre dans une plateforme. Leur matière première, c'est le contexte : définitions, règles de gestion, décisions passées, données de référence. L'ingénierie du contexte remplace l'ingénierie du prompt, et la mémoire de ce qui a été décidé devient un actif de l'entreprise. Leur autonomie progresse à mesure que ce contexte s'épaissit. Ils traitent seuls les situations connues et ne remontent aux humains que les vraies décisions.
Une plateforme qu'on n'ouvre plus. Aujourd'hui, une plateforme data se consulte par des écrans. Demain, elle sera surtout interrogée par des agents : les agents des métiers, assistants et agents maison, demanderont une définition ou un chiffre certifié directement aux agents de la plateforme, d'agent à agent. Plus personne n'ouvrira la plateforme ; elle deviendra une couche de back-office, gérée en arrière-plan comme l'est aujourd'hui le réseau.
La BI remodelée. Le tableau de bord figé, construit à la main et maintenu à la main, ne survivra pas à ce plan d'usine. Hex a montré la suite en premier : un espace où l'on pose une question, où un agent écrit la requête et le code, s'appuie sur les définitions partagées de l'entreprise pour ne pas les réinventer, produit le graphique et l'explication, et où l'humain relit, commente et publie. Dans ce modèle, les tableaux de bord deviennent des sorties d'agents, régénérées à la demande, versionnées et certifiées. L'analyste ne clique plus dans un outil ; il dialogue avec une chaîne de production et signe ce qui en sort.
Des interfaces pour trois gestes. Aujourd'hui, on parle à la machine par des tickets, des fils de discussion et des tableaux de bord. Demain, l'interface est faite pour les trois gestes qui restent aux humains : signer, questionner, contextualiser. Un rapport du matin qui ne montre que ce qui attend une décision. Une signature en un geste. Une explication dictée là où le chiffre apparaît, au moment où l'on s'en souvient. Les relais qui subsistent, ceux où l'humain doit trancher, passent de plusieurs jours à quelques minutes.
Les agents deviennent les opérateurs. Les humains décident, expliquent et signent.
Ce qui s'ouvre
C'est le moment de prendre de la hauteur. Pas pour défendre des postes. Pour décider où l'humain garde de l'impact sur une chaîne qui tourne sans lui. Cet impact se trouve en amont, dans le choix de ce qui compte et de ce qu'un indicateur veut dire, et en aval, dans l'explication que personne d'autre ne peut donner. Il se trouve aussi dans la confiance. Une chaîne opérée par des agents est plus traçable, plus testée et plus documentée qu'aucune équipe humaine ne l'a jamais été.
Il y a aussi un effet moins visible. Une plateforme tenue par des humains accumule de l'entropie : des tables que plus personne ne lit, des pipelines en double, des tableaux de bord que plus personne n'ouvre, et une facture cloud qui grossit avec. Des agents qui tournent en continu repèrent ces restes et les retirent au fil de l'eau, au lieu de les laisser s'empiler. La plateforme reste propre, et les coûts cloud baissent avec son entropie.
Et il faut regarder ce qui s'ouvre. Pendant vingt ans, les équipes data ont vécu saturées, à décider ce qu'elles ne feraient pas. Quand la chaîne tourne seule, la question s'inverse.
L'autonomie des agents ne retire rien aux humains. Elle leur rend le temps de faire ce que la chaîne ne faisait plus.
Ce qu'on peut nous opposer
« On ne peut pas faire confiance à une IA pour nos chiffres. »
La confiance ne se donne pas à une IA, elle se donne au cadre qui l'entoure : des droits limités, des essais hors production, des tests, des traces, un budget. C'est ce cadre qui rend chaque action vérifiable, et c'est lui qui se règle. On choisit, flux par flux, de laisser l'agent agir seul ou de garder un contrôle fin, signature comprise, et on desserre à mesure que la confiance se construit. Ce qui marche, c'est le bon cadre, avec une autonomie réglable.
« Les relais servent aussi à contrôler. »
En partie. Mais un contrôle qui arrive trois semaines après le travail ne contrôle plus grand-chose. Des tests automatiques à chaque étape et une signature au bon moment contrôlent mieux qu'une recette en fin de sprint.
« Notre organisation n'est pas prête. »
Aucune ne l'est. C'est le sujet de ce manifeste. Il ne s'agit pas de tout basculer d'un coup. On commence par quelques flux non critiques, on les rend autonomes, on mesure le délai, puis on étend.
« Toutes les projections annoncent plus d'emplois data, pas moins. »
C'est vrai. Le Bureau of Labor Statistics américain prévoit 35 % de data scientists en plus d'ici 2035, le Forum économique mondial 41 % d'analystes en plus d'ici 2030, et la Commission européenne plus de dix millions de professionnels de la donnée en 2030 contre 8,2 millions aujourd'hui. Ces projections prolongent la décennie passée, où chaque nouvel usage réclamait de nouvelles mains. Elles ne disent rien de ce qui se passe quand les mains sont des agents. Le temps 1 décrit ici leur est d'ailleurs compatible : le total tient. C'est après qu'elles se trompent.
« Et la sécurité, les données sensibles ? »
Des agents bien conçus sont plus traçables que des humains. Chaque action est journalisée, chaque droit est explicite, chaque modèle d'IA peut être choisi selon les règles de l'entreprise. Mais il faut le construire ainsi dès le départ.
Prédictions à revisiter
Des prédictions datées, à horizon court. À vérifier d'ici 2029.
- fin 2026Les premières entreprises de taille moyenne font tourner leur plateforme data avec moins de cinq personnes, sans perte de qualité.
- 2027Le délai entre une demande métier et une livraison fiable, tableau de bord, indicateur ou fonctionnalité, devient la métrique principale des équipes data, devant le nombre de tableaux de bord livrés.
- 2027La majorité des questions posées aux données d'entreprise passent par un agent du métier qui interroge, d'agent à agent, ceux de la plateforme, plus par un tableau de bord.
- 2027Une entreprise de cinquante personnes dispose d'une plateforme data aussi solide que celle d'un grand groupe en 2020, opérée par un seul pilote.
- 2027Les agents de domaine traitent seuls la majorité des incidents et des évolutions de schéma ; les humains ne voient plus que les décisions.
- 2027Les offres d'emploi data d'exécution reculent nettement ; celles de pilote, d'architecte et de gouvernance progressent.
- 2028Le sprint a disparu des équipes data, remplacé par un flux continu ponctué de signatures humaines.
- 2028Les outils de BI historiques ont intégré des agents ou perdu leur place ; le tableau de bord est une sortie régénérée, versionnée et certifiée.
- 2028La plateforme data n'est plus un produit que l'on ouvre mais une couche de back-office : les métiers parlent à leurs agents, qui parlent aux agents de la plateforme.
- 2028Opérer la plateforme data n'est plus un métier à part : c'est une responsabilité du management IT, au même titre que le réseau ou la sécurité.
- 2029Les premières plateformes data entièrement autonomes tournent sans rôle data dédié ; les humains n'y gardent que la gouvernance.
- Eliyahu Goldratt, The Goal (1984). La théorie des contraintes : accélérer un poste qui n'est pas le goulot n'accélère pas la chaîne.
- Robert Solow, « We'd better watch out », New York Times Book Review (1987). Le paradoxe de la productivité.
- Paul David, « The Dynamo and the Computer », American Economic Review (1990). Pourquoi l'électricité a mis une génération à produire ses gains.
- Commission européenne, Annual Report on European SMEs 2022/2023 (entreprises et emploi par classe de taille, UE-27, 2022) ; Eurostat, statistiques structurelles 2023 et enquête TIC 2025 (analyse de données en interne : 28 % des petites entreprises, 79 % des grandes).
- Bureau of Labor Statistics, Occupational Outlook Handbook, data scientists (275 600 postes aux États-Unis en 2025, +35 % d'ici 2035) ; Forum économique mondial, Future of Jobs Report 2025.
- Commission européenne / IDC, European Data Market Study 2024–2026, premier rapport (8,2 millions de professionnels de la donnée dans l'UE en 2024, au sens large).
- Manifeste agile (2001), agilemanifesto.org.